ChatGPTの設定画面を開くと、「メモリ」「保存したメモリを参照する」「チャット履歴を参照 codeする」といったスイッチが並んでいる。オンのままでいいのか、切ったほうが無難なのか。CodexやClaude Codeまで使い始めると、今度は AGENTS.md や CLAUDE.md とメモリの違いまで気になってくる。
先に白状しておくと、以前の僕は「メモリは完全OFF推奨」だった。当時は OpenAI も Anthropic も、メモリの仕様がとても使えるものではなかったから、切っていただけの話だ。
では今はどうか。
 マコト
ちなみに今の俺は、メモリON推奨派だからな笑
ChatGPTもCodexもClaudeも、2026年10月の時点で、メモリは「何を覚えたかが見える」「覚える範囲を区切れる」「覚えた中身を直せる」ものになっている。だから僕は全部オンで使っている。そのうえで効いてくるのが、必ず守らせたいルールは自分で書き、経緯や好みは記憶に任せるという置き場所の分け方だ。
この記事では、ChatGPT、Codex、Claudeアプリ、Claude Codeの4つについて、オンにする方法と、記憶の範囲の区切り方を順に見ていく。仕様の調べものは Claude Code に任せ、OpenAI と Anthropic の公式ヘルプ・公式ドキュメントで確かめてもらった。日付は特に断りがなければ2026年10月7日時点のものだ。

2026年のAIメモリは「見える・区切れる・直せる」
今のAIのメモリは、4製品とも同じ方向を向いている。勝手に覚えて黙って使う箱ではなく、中身を確かめ、範囲を決め、必要なら直せる道具になった。最後に比較表を置くが、まずは共通する三つの性質を押さえておくと、各製品の設定画面が読みやすくなる。
メモリはオンで使う派です
僕がメモリをオンにしている理由は単純で、毎回同じ前提を説明し直すのが面倒だからだ。自分の立場、よく使う道具、文章の好み、進めている作業。こういうものをAIが覚えていてくれると、会話の一往復目から本題に入れる。
ただし、なんでも記憶に任せるわけではない。「この形式で必ず出力する」「このフォルダは触らない」のような、外れたら困るルールは、AGENTS.md や CLAUDE.md、カスタム指示といった自分で書くファイルや設定に置く。記憶は、そこに書くほどではない経緯や好みを拾う係だ。この分担は僕の好みというより、後で見るとおり各社の公式ドキュメントがそう書いている。
何を覚えたかが見えるようになった
「見える」の代表例は、ChatGPTの Sources(ソース) だ。2026年5月5日から全コンシューマープランに入った機能で、返答の下のアイコンを押すと、その返答のパーソナライズに使われた過去のチャット、保存メモリ、カスタム指示、ファイル、Gmail が表示される(ChatGPT リリースノート)。
保存メモリそのものも、2025年10月から自動の優先順位付け、検索、並べ替え、バージョン履歴と復元ができるようになっている。Claudeアプリでは覚えた内容が「Topics」として一覧され、CodexとClaude Codeに至っては記憶がそのままファイルとして手元に置かれる。
「区切れる」はプロジェクト単位の記憶、「直せる」は訂正・編集・削除の手段のことだ。どちらも製品ごとにやり方が違うので、ここから一つずつ見ていく。
 じぴこ
覚えた中身が見えて、範囲も決められるなら、あとは置き方次第ってことですね。
ChatGPTのメモリ:オンにして範囲を区切る

ChatGPTのメモリは「設定 > パーソナライズ > メモリ」にある(Memory in ChatGPT)。アカウントによって画面の構成が違い、Memory、Reference saved memories(保存したメモリを参照する)、Reference chat history(チャット履歴を参照する)、Memory summary、Manage、Saved memories といった項目が出る。全部同じ画面に出るとは限らないので、自分の画面にある名前で読み替えてほしい。
保存メモリとチャット履歴の参照
ChatGPTの記憶は2種類ある。
一つは保存メモリ(Saved memories)。「これを覚えて」と頼んだもの、または ChatGPT が今後役に立つと判断したものが保存される。ここで覚えておきたいのは、保存メモリは元のチャットとは別に保管されるという点だ。元のチャットを削除しても、そこから作られた保存メモリは残る。消したいときは、設定画面から削除するか、ChatGPTに「それは忘れて」と頼む。
もう一つはチャット履歴の参照(Reference chat history)。こちらは過去の会話全体から関連する情報を拾ってくる。オフにすると、履歴から得た情報は30日以内に削除される。なお、保存メモリの参照をオフにすると、チャット履歴の参照も一緒にオフになる。逆に、チャット履歴の参照だけを切っても保存メモリは消えない。
僕のおすすめは両方オン。履歴の参照まで入れておくと、「先週の続き」が本当に続きから始まる。
Improved memoryと従来方式
2026年6月4日から、Improved memory(改善されたメモリ) が米国の Plus と Pro から順に提供されている(リリースノート)。個別の項目を箇条書きで溜める方式ではなく、関連する情報の広い要約を自動で更新し続ける方式で、メモリの容量も2倍になった。
箇条書きのほうが管理しやすい人は、従来方式(legacy saved memories)に切り替えられる。2026年6月12日からはメモリ概要を直接訂正できるようになり、3点メニューから「削除してメモリをオフにする」も選べる。要約方式は便利な反面、中身が文章でまとまるぶん、ときどき概要を開いて目を通しておくと安心だ。
プロジェクト専用メモリで仕事ごとに分ける
範囲を区切る主役は、Project-only memory(プロジェクト専用メモリ) だ(Projects in ChatGPT)。
既定の Default memory では、プロジェクト内のチャットは保存メモリを参照し、同じプロジェクトの他の会話も使う。Plus と Pro では、プロジェクト外のチャットまで参照することがある。一方 Project-only memory にすると、そのプロジェクトはプロジェクト外の会話を参照せず、プロジェクトの情報も外へ出ていかない。2026年8月14日からは、作成済みのプロジェクトでも設定から切り替えられる(共有する前のプロジェクトに限る)。共有プロジェクトは自動的に専用メモリになり、変更できない。
さらにプロジェクトには専用の指示を書ける。プロジェクトの指示は、そのプロジェクトの中ではグローバルのカスタム指示より優先される。つまり、
- 普段の雑談や相談は、グローバルのメモリとカスタム指示で
- 記事制作やクライアントの案件は、プロジェクト専用メモリとプロジェクトの指示で
と分けておけば、メモリをオンにしたまま、仕事ごとに記憶が混ざらない。フォルダを分けて書類を整理するのと同じ感覚だ。
じぴこプロジェクトごとに引き出しを分ける感じですね。ただ、ChatGPTは既定だと外も見ちゃうので、専用メモリを選ぶのを忘れないでね。
残したくない用件は一時チャットへ
一回きりの用件や、記憶に残したくない相談は一時チャット(Temporary chat) に逃がす。2026年8月27日からは、始める前に Personalized(今のメモリやカスタム指示を使う)か Unpersonalized(使わない)を選べるようになった。どちらを選んでも、一時チャットから新しいメモリは作られない。
ちなみにカスタム指示は、メモリとは別物としてヘルプに明記されている。文字数は Free と Go が1,500字、Plus 以上が5,000字だ(カスタム指示)。必ず守ってほしい書き方の決まりは、記憶ではなくこちらに書く。
Codexのmemories:手元に溜まる自動の記憶

Codex にもメモリがある。名前は memories。ここで一番大事なのは、これが ChatGPT のメモリとは別物だということだ。公式ドキュメントにも「ChatGPT の Web 版は ChatGPT のメモリを使い、ローカルの Codex は別のローカルの記憶ストアと設定を使う」と書かれている(Codex Memories)。
ChatGPTのメモリとは別物で、既定はオフ
もう一つ大事なのが、Codex の memories は既定でオフという点。ChatGPTのメモリをオンにしていても、Codex側は何も覚えていない。オンにする方法は二つある。
- ChatGPT デスクトップアプリの「設定 > パーソナライズ」で Enable memories をオンにする
~/.codex/config.tomlに次の行を書く
[features]
memories = true
記憶は ~/.codex/memories/ の下にファイルとして保存される。中身は要約、長く残す項目、最近の材料、その根拠になった資料だ。
会話が落ち着いてから後で作られる
Codex の記憶は、会話中にその場で書かれるのではない。過去のチャットからバックグラウンドで後から作られる。進行中のチャットや短いチャットは飛ばし、しばらく放置されたチャットだけが材料になる。既定では6時間止まったチャットが対象だ(min_rollout_idle_hours)。生成時には秘密情報が伏せられ、Codex の利用枠の残りが25%を切っているときは生成自体を見送る(min_rate_limit_remaining_percent)。
一日の終わりに日報をまとめるようなものだが、日報と違うのは、書くのが本人ではなく Codex で、公式も「生成された状態ファイルとして扱い、手で編集することを主な操作手段にしない」と書いていることだ。中身を確かめるのはいいが、直したいことがあるなら記憶ファイルではなく、後で書く AGENTS.md の側に書く。
/memoriesで会話ごとに切り替える
ChatGPT デスクトップアプリと Codex の TUI では、/memories で今の会話の扱いを選べる。その会話で既存の記憶を使うか、その会話を将来の記憶の材料にするか、の二つだ。全体の設定は変わらない。
config.toml の [memories] には、もう少し細かい設定がある。
generate_memories:新しい会話を記憶の材料にするかuse_memories:既存の記憶を次のセッションに入れるかdisable_on_external_context:MCP のツールや Web 検索を使った会話を材料から外すか
外部のページや検索結果が混ざった会話を記憶にしたくなければ、disable_on_external_context = true にしておく。
既定オフなのは要注意ですね。ChatGPT側でオンにしてても、Codexは別に覚えてないですから。
Computer Historyは便利だが扱い注意
記憶の範囲をPCの操作にまで広げる機能もある。Computer History(以前の Chronicle を作り直したもの)だ(Computer History)。macOS のデスクトップアプリ専用で、Pro、Business、Enterprise で使える。既定はオフで、memories もオンにしておく必要がある。
Claudeアプリのメモリ:プロジェクトごとに分かれる記憶
Claude のアプリ(Web、デスクトップ、モバイル)にもメモリがある。ChatGPT との一番の違いは、最初からプロジェクトごとに記憶が分かれていることだ。
全プランに行き渡り、個人プランは既定オン
Claude のメモリは、2025年9月11日に Team、9月18日に Enterprise、10月23日に Max と Pro へ広がり、2026年3月2日から Free を含む全ユーザーが使えるようになった(Claude リリースノート)。2026年8月25日からは、Free、Pro、Max では既定でオン、Team と Enterprise では既定でオフになり、組織の管理者が使うかどうかを決める。
設定の場所は Settings > Memory。過去のチャットを検索して参照する「Search and reference chats」は有料プラン(Pro、Max、Team、Enterprise)だけの機能だ。
プロジェクトごとの記憶とTopicsの編集
Anthropic は公式に「各プロジェクトはそれぞれ別のメモリを持つ」と書いている(Claude memory)。プロジェクトの中で覚えたことは、他のプロジェクトや通常のチャットには混ざらない。ChatGPT ではプロジェクト専用メモリを選ぶ必要があったが、Claude ではこれが最初から既定だ。
覚えた内容は Settings > Memory に「Topics」として一覧され、編集や削除ができる(Use Claude’s chat search and memory)。止め方は二つあって、Pause は記憶を残したまま使うのを止める。Reset は全部消すので元に戻せない。しばらく休ませたいだけなら Pause を選ぶ。
プロジェクトには、自分で書く「プロジェクトの指示」と、資料を置く「プロジェクトの知識」もある。ここは ChatGPT と同じで、外れたら困る決まりは指示に、日々の経緯は記憶に、と分けておく。
シークレットチャットと他社AIからの取り込み
記憶に残したくない会話は、ゴーストのアイコンから始めるシークレットチャットを使う。履歴にもメモリにも残らない。ChatGPT の一時チャットに当たる機能だ。
面白いのが、他のAIで育てた記憶を Claude に持ち込める機能だ。2026年3月2日から実験的機能として提供されていて、Claude が用意するプロンプトを他社のAIに貼って記憶を書き出させ、その結果を Settings > Memory の「Start import」に貼る(メモリの取り込みと書き出し)。仕事に関わる内容が中心に取り込まれ、仕事と関係のない個人的な情報は残らないことがある。実験的機能なので、取り込んだ後は Topics を一度見ておきたい。
じぴこ引っ越しのときの荷造りみたいですね。届いたら、箱の中身は一度確かめましょう。
Claude Codeのメモリ:CLAUDE.mdとauto memoryの二本立て
Claude Code は、ルールと記憶の置き場所が最初からはっきり分かれている。ルールは CLAUDE.md、記憶は auto memory(自動メモリ)。この二本立てが、この記事で言いたい「分けて置く」をそのまま形にしている(Claude Code memory)。
ルール側:CLAUDE.mdとAGENTS.md
CLAUDE.md は自分で書くルールのファイルで、置く場所によって効く範囲が変わる。
- 組織の管理用(macOS では
/Library/Application Support/ClaudeCode/CLAUDE.md) - 自分用:
~/.claude/CLAUDE.md - プロジェクト用:
./CLAUDE.mdまたは./.claude/CLAUDE.md - 自分だけのプロジェクト用:
./CLAUDE.local.md(Git に入れない)
特定のファイルにだけ効かせたいルールは .claude/rules/*.md に置き、paths: で対象を絞れる。@パス と書けば別のファイルを読み込める(最大4段まで)。実際にどのファイルが読み込まれたかは /context、一覧と編集は /memory で確かめられる。
Codex と併用する人にうれしいのが、AGENTS.md の扱いだ。Claude Code は v2.1.277 から AGENTS.md を直接読めるようになった。ただし既定では、今のフォルダかその上に CLAUDE.md が一つも無いときだけ AGENTS.md を読む。CLAUDE.md と AGENTS.md の両方を置くなら、CLAUDE.md に @AGENTS.md と一行書いて読み込ませる方法が公式に案内されていて、二重に読み込まれることもない。
記憶側:MEMORY.mdの索引と4つの種類
auto memory は、Claude が作業中に「これは次からも役に立つ」と判断したことを書き留める仕組みだ。保存先は ~/.claude/projects/<プロジェクト>/memory/。Git のリポジトリごとに一つで、worktree の間でも共有される。保存はマシンの中だけで、他のマシンやクラウドとは共有しない。
中身は、索引の MEMORY.md(1件1行)と、1件1ファイルの本文でできている。本の索引と本文の関係に近い。起動時に読み込まれるのは MEMORY.md の先頭200行または25 KB のどちらか先に達したところまでで、本文は必要になったときに Claude が開きに行く。逆に言えば、索引が長くなりすぎると、はみ出した部分は起動時に読まれない。
記憶には4つの種類があり、ファイル先頭の type に記録される。
user:あなたの役割や専門、作業の好みfeedback:作業のやり方への指摘と、うまくいったやり方project:進行中の作業や決定事項のうち、コードや Git の履歴からは分からないものreference:課題管理やダッシュボードなど、外部の参照先
覚えないものと止め方
auto memory は、何でも溜め込むわけではない。コードや Git の履歴を読めば分かること、CLAUDE.md にすでに書いてあることは保存しない。毎回書くのでもなく、将来の会話で役に立つかどうかで Claude が判断する。ルールは CLAUDE.md、記憶はそれ以外、という線引きが仕様に組み込まれている。
そして Codex の memories と大きく違うのが、記憶がふつうの Markdown で、人が読んで直せることだ。間違って覚えたことがあれば、ファイルを開いて直すか消せばいい。止めたいときは、/memory のトグル、設定ファイルの autoMemoryEnabled: false、環境変数 CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 のどれかを使う。
じぴこ自分で読めて自分で直せるのは安心ですね。間違いを見つけたら、その場で消しちゃえばいいんですから。
ルールと記憶を分けて置く:僕の実運用
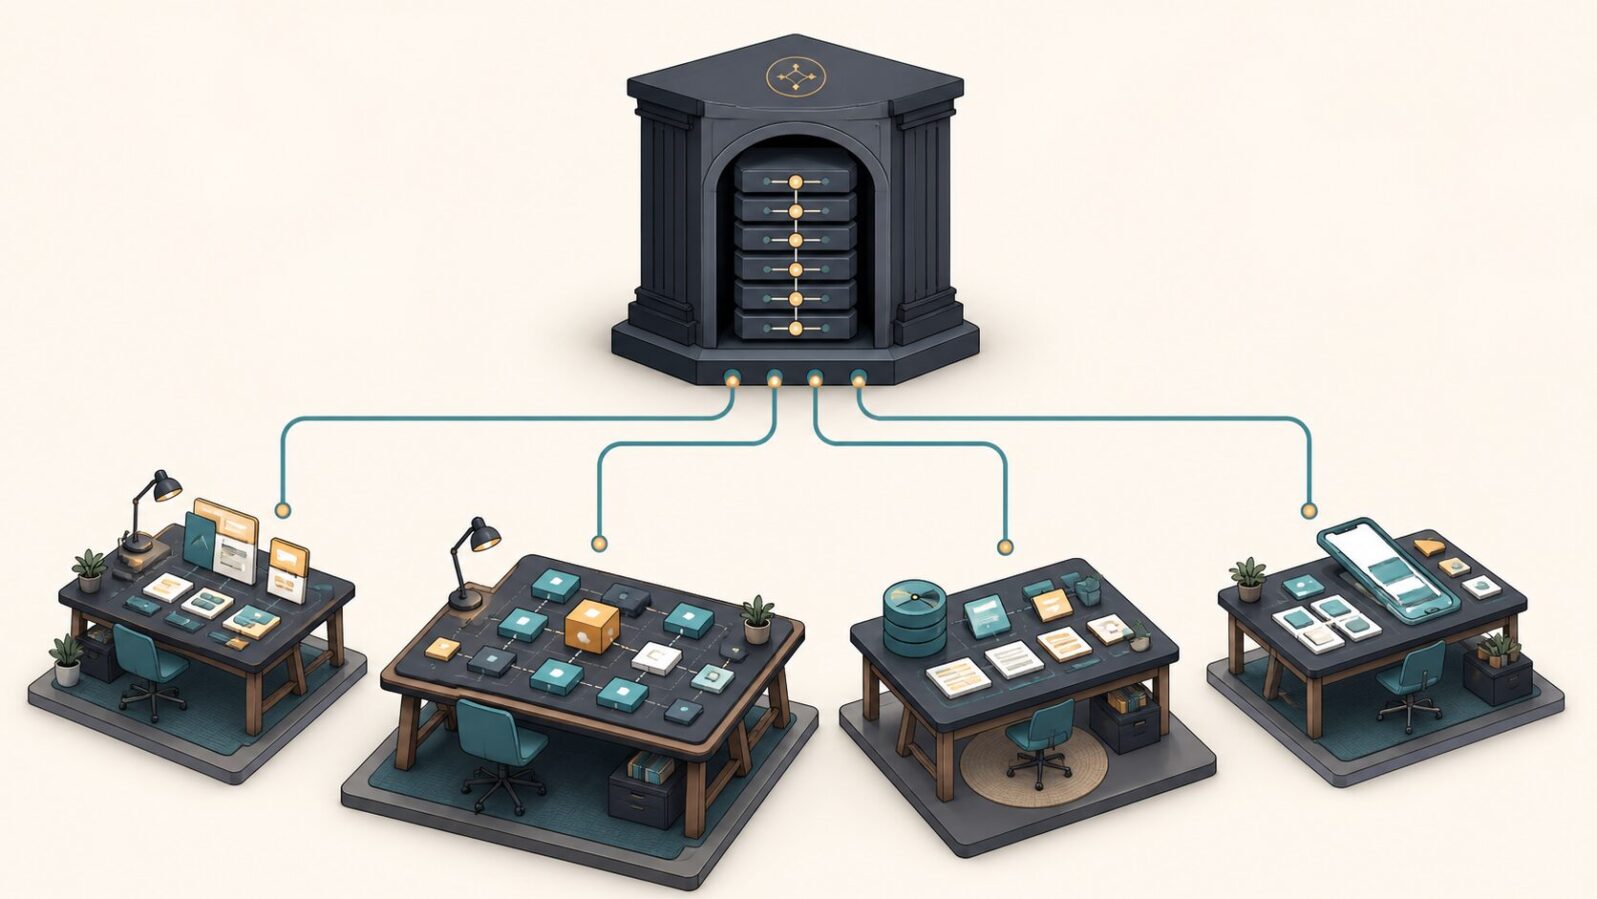
ここまで4製品を見てきたが、どれも結局は同じ形に落ち着く。社内の規程と担当者のメモ帳の関係だ。必ず守ってほしいことは誰でも読める規程に自分で書き、日々の経緯や好みは担当者のメモに任せる。Codex の公式ドキュメントもはっきり「必ず守らせたいチームの決まりは AGENTS.md かリポジトリ内の文書に置き、記憶は補助的に思い出すための層として扱う」と書いている。
僕の手元で、これがどう効いているかを数字で見てもらおう。Claude Code に自分の環境のファイルを数えてもらった結果だ。
Codexの記憶は4,884行に育った
Codex(codex-cli 0.160.1)は memories をオンにして使っている。~/.codex/memories/ を覗くと、こうなっていた。
| ファイル | 大きさ |
|---|---|
MEMORY.md | 約540 KB、4,884行(作業のまとまりが107個) |
memory_summary.md | 約10 KB、117行 |
raw_memories.md | 約991 KB、11,329行 |
rollout_summaries/ | 194ファイル |
4,884行である。人が全部読んで監査する量ではない。
4,884行って……もう日記じゃなくて年鑑ですね。
これは欠点ではないと僕は考えている。自動で作らせた記憶は、放っておけばこのくらい育つ。だからこそ、絶対に外したくないルールを記憶の側に混ぜてはいけない。記憶は大量で、自動で入れ替わり、手で直す前提でもない。ルールは短く、自分で書き、いつでも読み返せる場所に置く。量の差そのものが、置き場所を分ける理由になっている。
Claude Codeの索引は55行
一方、Claude Code の auto memory はこうだ。この記事を書いているフォルダの memory/ には56ファイルがあり、索引の MEMORY.md は55行、約9 KB。起動時の読み込み上限(200行か25 KB)に十分収まっている。
索引の各行には「何についてのメモか」と「いつ読むか」だけを書き、失敗の教訓や細かい数字は本文のファイルに置く。索引は毎回読み込まれるので、そこに教訓を常駐させると関係のない場面でまで引きずられるからだ。本文は必要なときだけ開かれるので、どれだけ細かく書いても邪魔にならない。
同じAGENTS.mdを二つのエージェントに読ませる
ルールの側は、Codex と Claude Code で一本にしている。作業フォルダに AGENTS.md を置き、同じフォルダの CLAUDE.md には @AGENTS.md とだけ書く。Codex は AGENTS.md を直接読み、Claude Code は CLAUDE.md 経由で同じ AGENTS.md を読む。規約を書き換えるときは AGENTS.md だけ直せば、両方に効く。
まとめると、僕の環境の分担はこうなる。
- 必ず守るルール:AGENTS.md(Codex と Claude Code で共有)、CLAUDE.md、ChatGPT のカスタム指示とプロジェクトの指示
- 経緯・好み・指摘:各製品のメモリ(Codex の memories、Claude Code の auto memory、ChatGPT と Claude アプリのメモリ)
ルールは自分で書く。記憶はAIに書かせる。この線を一本引いておくだけで、メモリをオンにしたまま安心して使える。
4つを並べて比べる:用途別のおすすめ設定
最後に4製品を一つの表にまとめ、用途別のおすすめを置いておく。
比較表
| ChatGPT | Codex | Claude アプリ | Claude Code | |
|---|---|---|---|---|
| ルールを置く場所 | カスタム指示/プロジェクトの指示 | AGENTS.md | プロジェクトの指示 | CLAUDE.md(AGENTS.md も可) |
| 記憶を書くのは | ChatGPT(頼むことも可) | Codex がバックグラウンドで後から | Claude | Claude が作業中に判断 |
| 中身の確かめ方 | 設定画面と Sources | ~/.codex/memories/ のファイル | Topics の一覧 | ふつうの Markdown |
| 手で直せるか | 概要の訂正・項目の削除 | 手で直す前提ではない | 編集・削除できる | 自由に直せる |
| 記憶の範囲 | アカウント全体(プロジェクト専用も可) | Codex のホームごと | プロジェクトごとに独立 | リポジトリごと |
| 既定 | オン | オフ | オン(Free/Pro/Max) | オン |
| 止め方・逃がし先 | 設定でオフ/一時チャット | 設定でオフ//memories | Pause・Reset/シークレットチャット | /memory のトグル・環境変数 |
用途別のおすすめ
- 日常の相談や調べもの:ChatGPT と Claude アプリのメモリをオン。ChatGPT はチャット履歴の参照もオンにしておくと、前の話の続きから始められる。
- 記事制作やクライアントの案件:仕事ごとにプロジェクトを作る。ChatGPT ではプロジェクト専用メモリを選び、決まりごとはプロジェクトの指示に書く。Claude アプリは最初からプロジェクトごとに分かれている。
- 記憶に残したくない一回きりの用件:ChatGPT は一時チャット(必要なら Unpersonalized)、Claude はシークレットチャット。
- Codex でのコーディング:memories を自分でオンにする。守らせたいルールは AGENTS.md に書き、外部の情報が混ざった会話を記憶にしたくなければ
disable_on_external_context = true。 - Claude Code:auto memory はオンのまま。ルールは CLAUDE.md に書き、
MEMORY.mdの索引は200行以内に保つ。 - Codex と Claude Code の併用:AGENTS.md を一本の正本にして、CLAUDE.md に
@AGENTS.mdと書く。
今日やることは一つでいい。いちばん使っているAIの設定画面を開いて、メモリがオンになっているかを確かめる。Codex を使っているなら、そこはたぶんまだオフだ。オンにしたら、外れたら困るルールを一つだけ、AGENTS.md かカスタム指示に書いてみてほしい。記憶とルールの置き場所が分かれた瞬間から、メモリはちゃんと味方になる。
じぴこまずはスイッチの確認から、ですね。Codexの人は特に!